

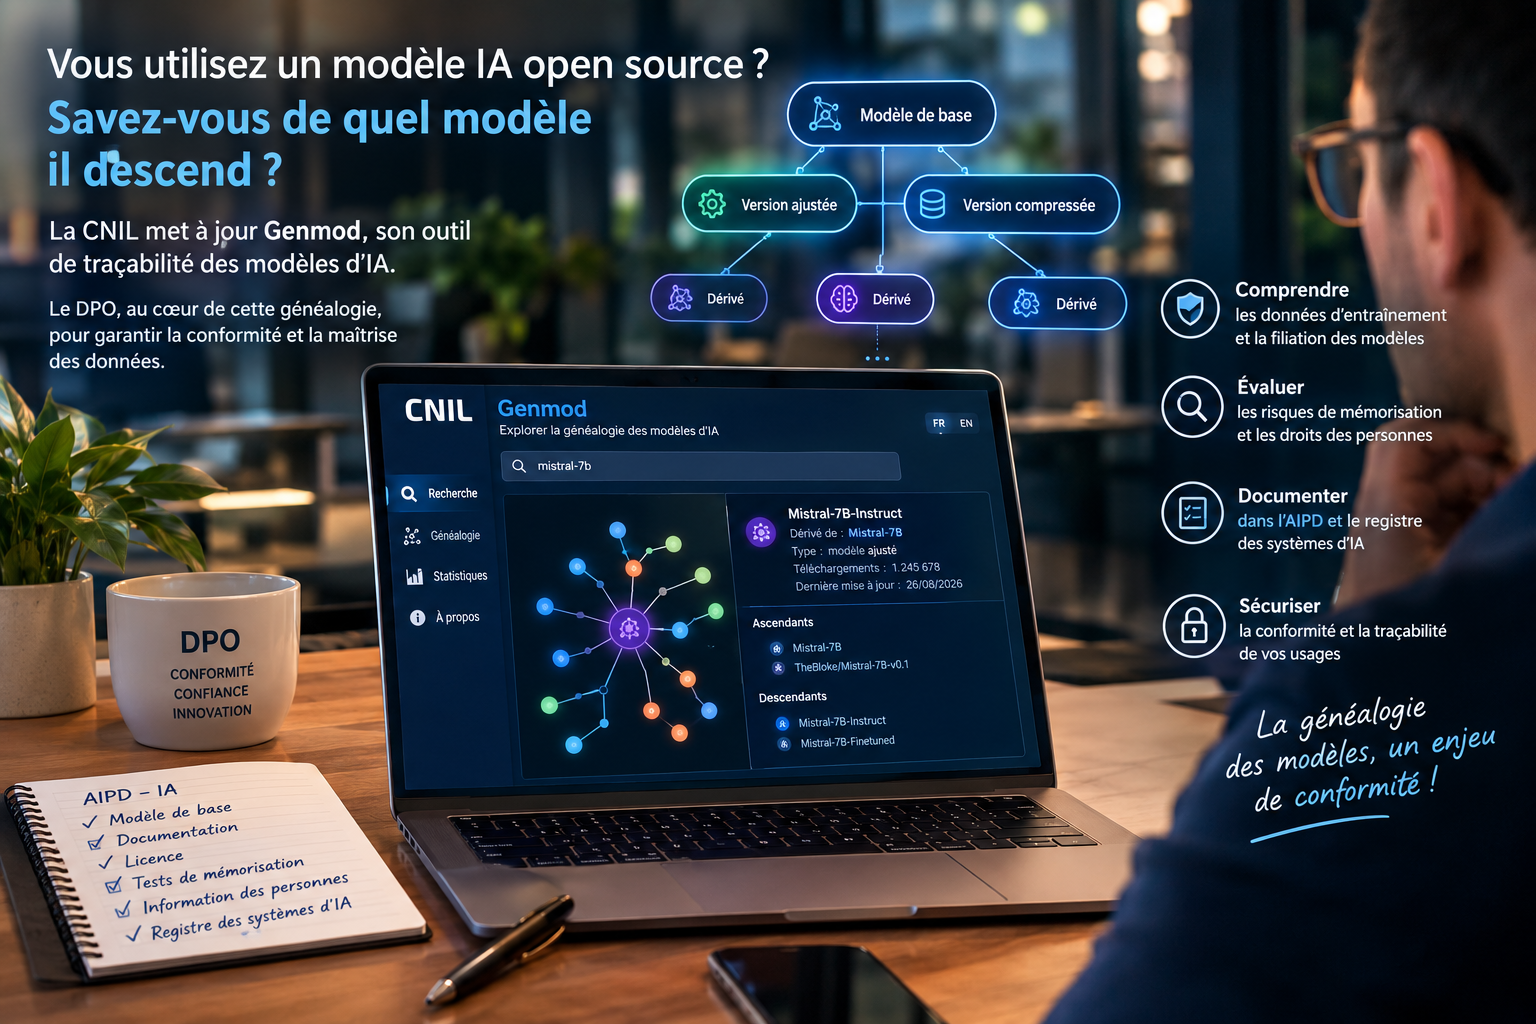
Vous déployez un modèle IA open source téléchargé sur une plateforme publique. Savez-vous de quel modèle il descend ? La CNIL a mis à jour le 26 août 2026 un outil qui reconstitue cette filiation, et la réponse surprend souvent : le modèle que vous croyez neutre hérite parfois d’un corpus d’entraînement dont personne dans votre organisation n’a entendu parler.
Pourquoi la généalogie d’un modèle d’IA concerne-t-elle le DPO ?
Un modèle publié en source ouverte est rarement construit à partir de zéro. Il est le plus souvent dérivé d’un modèle de base, par ajustement fin, par compression ou par fusion avec d’autres modèles.
Ce détail change tout pour la conformité. Les données d’entraînement, elles, ne se transmettent pas dans la fiche descriptive. Elles restent dans les poids du modèle de base, et le modèle dérivé les emporte avec lui.
Deux conséquences pratiques. D’abord, un modèle peut restituer des fragments mémorisés de son corpus d’origine, ce que la recherche documente sous le nom de mémorisation. Ensuite, l’exercice des droits par une personne dont les données figurent dans ce corpus se heurte à un responsable de traitement qui ignore l’existence du corpus.
Qu’est-ce que Genmod, l’outil mis à jour par la CNIL ?
Genmod est un démonstrateur développé par le service de l’intelligence artificielle de la CNIL avec le LINC. Il explore la généalogie des modèles diffusés sur HuggingFace et affiche, pour un modèle donné, ses ascendants et ses descendants.
La version publiée le 26 août 2026 apporte une interface en français et en anglais, une recherche sans limite de profondeur en une vingtaine de secondes, un tri par nombre de téléchargements et une actualisation hebdomadaire automatisée des données.
L’outil est accessible librement. Il ne délivre aucune attestation de conformité : il produit une cartographie de filiation, à interpréter ensuite. C’est déjà considérable quand on part d’une page vide, et cela complète utilement ce que change l’arrivée des modèles à poids ouverts pour le DPO.
Modèle de base, version ajustée, version compressée : qu’est-ce qui change ?
Toutes les dérivations ne posent pas les mêmes questions. Le tableau ci-dessous situe les trois cas les plus courants.
| Type de modèle | Ce qui est ajouté | Point de vigilance pour le DPO |
|---|---|---|
| Modèle de base | Le corpus d’entraînement initial | Origine et licéité du corpus, information des personnes, mémorisation possible |
| Version ajustée (fine-tuning) | Un jeu de données métier, parfois interne | Le corpus d’origine reste présent, et le jeu ajouté devient un traitement à part entière |
| Version compressée ou fusionnée | Rien, ou plusieurs héritages combinés | La filiation devient illisible sans outil, et plusieurs corpus se superposent |
Dans les trois cas, la question posée au fournisseur est la même : de quel modèle votre modèle descend-il, et quelle documentation d’entraînement accompagne cet ancêtre ?
Qui est responsable du corpus d’entraînement ?
Celui qui entraîne le modèle de base traite les données du corpus. Celui qui déploie une version dérivée n’entraîne pas, mais il met en oeuvre un système susceptible de restituer ces données.
La position devient inconfortable dès qu’une personne demande l’effacement de données présentes dans le corpus. Sans connaissance de l’ascendance, vous ne pouvez ni instruire la demande ni la réorienter vers le bon acteur. Les critères récents du CEPD sur l’anonymisation appliquée à l’IA aident à trancher ce qui reste ou non une donnée personnelle dans un modèle.
Rattacher chaque modèle déployé à sa fiche de traitement, à son analyse de risque et à sa documentation d’origine devient vite ingérable dans un tableur. DPO SUITE relie vos systèmes d’IA à leurs traitements et conserve la preuve de chaque analyse, ce qui rend la filiation opposable le jour d’un contrôle.
Comment intégrer la généalogie dans votre analyse d’impact ?
Avant toute mise en production d’un modèle ouvert, six vérifications suffisent à sécuriser le dossier.
- Identifier le modèle de base dont dérive la version retenue, et le noter dans la fiche
- Récupérer la documentation d’entraînement de cet ancêtre, ou constater par écrit son absence
- Vérifier la licence, qui peut restreindre certains usages malgré la mention « open source »
- Tester la restitution de données personnelles par quelques requêtes ciblées
- Décrire dans la mention d’information la nature du modèle et la voie d’exercice des droits
- Verser le tout au registre des systèmes d’IA, distinct du registre des traitements
Une absence de documentation n’interdit pas le déploiement. Elle change le niveau de risque retenu, et donc les mesures à prévoir. C’est cette traçabilité du raisonnement qui est attendue, pas une certitude impossible à obtenir.
Source officielle : annonce de la CNIL du 26 août 2026.
FAQ
Un modèle open source est-il plus conforme qu’un modèle fermé ?
Non, l’ouverture des poids ne dit rien de la licéité du corpus d’entraînement. Elle facilite en revanche l’audit, l’hébergement maîtrisé et la vérification de la filiation. Un modèle fermé bien documenté peut se révéler plus simple à qualifier qu’un modèle ouvert sans aucune documentation.
Faut-il déclarer un modèle d’IA dans le registre des traitements ?
Le registre décrit des traitements, pas des outils. Vous inscrivez donc l’usage, par exemple l’assistance à la rédaction ou le tri de demandes, en mentionnant le modèle employé comme moyen. Le registre des systèmes d’IA attendu au titre du règlement européen vient en complément, sans se substituer au premier.
Peut-on effacer des données personnelles d’un modèle entraîné ?
Pas au sens d’une suppression en base. Les données sont diffusées dans les poids. Les réponses possibles sont le filtrage en sortie, le réentraînement partiel, ou la suppression du modèle. Documentez la mesure retenue et sa limite, plutôt que de promettre un effacement irréalisable.
La mémorisation d’un modèle est-elle fréquente ?
Elle reste marginale en volume mais démontrée, surtout pour les contenus rares ou répétés dans le corpus. Un nom associé à une adresse peu commune se restitue plus facilement qu’une information banale. Quelques requêtes ciblées lors des tests suffisent à repérer les cas les plus visibles.
Que faire si le fournisseur ne documente pas son corpus ?
Consignez le refus ou l’absence de réponse par écrit, relevez le niveau de risque dans l’analyse d’impact et prévoyez des mesures compensatoires : restriction des usages sensibles, revue humaine des sorties, interdiction des données particulières en entrée. La décision reste possible, elle devient simplement motivée.